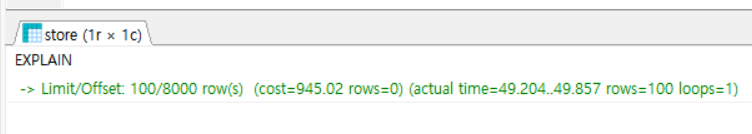
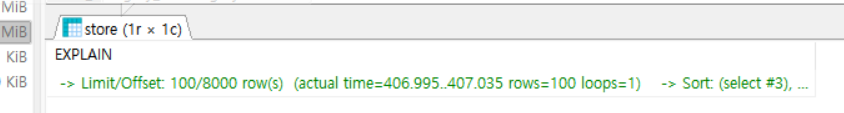
자주 사용되는 가게 검색 API의 응답시간이 약 400ms가 나왔습니다 400ms는 프론트에서 렌더링하는 과정까지 포함하면 1초를 넘길수도 있습니다. 최대 100ms을 목표로 응답속도를 개선해보았습니다. 쿼리는 페이징이 적용되어있기때문에 count쿼리 + 메인쿼리로 이루어져 있습니다.
Count쿼리의 문제점
select
        store0_.store_id as store_id1_10_
    from
        store store0_
    left outer join
        store_keyword storekeywo1_
            on store0_.store_id=storekeywo1_.store_id
    inner join
        keyword keyword2_
    where
        storekeywo1_.keyword_id=keyword2_.keyword_id
        and store0_.status=?
        and keyword2_.name=?
        and (
            store0_.name like ? escape '!'
        )
    group by
        store0_.store_id
데이터베이스에서 일대다 관계를 JOIN하면서 데이터뻥튀기 현상이 발생합니다.
이 현상을 해결하기 위한 방법 중 하나는 GROUP BY나 DISTINCT 같은 연산을 사용하여 중복을 제거하는 것입니다. 그러나 이러한 연산은 쿼리의 비용을 증가시킵니다.
GroupBy가 비용이 큰 이유
정렬 연산: GROUP BY를 실행하면 데이터베이스는 먼저 해당 필드를 기반으로 데이터를 정렬합니다. (기본적으로 정렬과정은 큰 비용을 필요로 합니다)
임시 테이블 생성: 그룹화된 결과를 저장하기 위해 데이터베이스는 임시 테이블을 생성하고 관리해야 합니다. 이는 추가적인 메모리 및 디스크 I/O를 요구합니다.
해결법
이를 해결하기 위한 새로운 접근법으로 "다"에 해당하는 테이블을 FROM 절에 배치함으로써 데이터 뻥튀기 현상을 방지하고, 따라서 GROUP BY 연산 없이도 중복을 제거할 수 있습니다.
 select
        store1_.store_id as col_0_0_
    from
        store_keyword storekeywo0_
    inner join
        store store1_
            on storekeywo0_.store_id=store1_.store_id
    inner join
        keyword keyword2_
            on storekeywo0_.keyword_id=keyword2_.keyword_id
    where
        store1_.status=?
        and keyword2_.name=?
        and (
            store1_.name like ? escape '!'
        )
메인 쿼리의 문제점
select
        store0_.store_id as store_id1_10_,
        store0_.address as address2_10_,
        store0_.business_name as business3_10_,
        store0_.business_number as business4_10_,
        store0_.business_start_date as business5_10_,
        store0_.category_id as categor11_10_,
        store0_.name as name6_10_,
        store0_.member_id as member_12_10_,
        store0_.phone as phone7_10_,
        store0_.reason_for_rejection as reason_f8_10_,
        store0_.request_date as request_9_10_,
        store0_.status as status10_10_
    from
        store store0_
    left outer join
        review reviewlist1_
            on store0_.store_id=reviewlist1_.store_id
    left outer join
        image storeimage2_
            on store0_.store_id=storeimage2_.store_id
    left outer join
        likes likeslist3_
            on store0_.store_id=likeslist3_.store_id
    left outer join
        category category4_
            on store0_.category_id=category4_.category_id
    left outer join
        store_keyword storekeywo5_
            on store0_.store_id=storekeywo5_.store_id
    where
        store0_.status=?
        and ?=?
        and (
            exists (
                select
                    1
                from
                    store_keyword storekeywo6_ cross
                join
                    keyword keyword7_
                where
                    store0_.store_id=storekeywo6_.store_id
                    and storekeywo6_.keyword_id=keyword7_.keyword_id
                    and keyword7_.name=?
            )
        )
        and (
            store0_.address like ? escape '!'
        )
        and ?=?
    group by
        store0_.store_id
    order by
        (select
            count(reviewlist8_.store_id)
        from
            review reviewlist8_
        where
            store0_.store_id = reviewlist8_.store_id) asc limit ?
예상했던 것과 다른 sql문
생각보다 많은 Join 수
예상치 못한 서브쿼리
인덱스를 제대로 활용 못한 점
해결방안 - 비정규화
읽는 시간을 최적화하도록 데이터베이스를 설계하는 과정을 비정규화 라고 합니다.
비정규화의 장점
시간 단축
쉬운 쿼리 작성
비정규화의 단점
데이터 갱신이나 삽입 비용이 높음
데이터의 무결성 해침
데이터 중복저장으로 인한 추가 저장공간 확보 필요
추가적으로 현재 프로젝트에서 비정규화로 리뷰 평균점수와 같은것들을 계산해서 넣었을때 동시성 문제의 우려
비정규화의 장점에 비해 단점의 비용이 크다고 판단하였습니다.
또한 orderby에 인덱스컬럼이 들어가더라도 인덱스컬럼속도와(133ms) 인덱스 아닌 컬럼(144ms)과의 속도차이가 미미했습니다.
결론적으로는 비정규화를 하는데 드는 비용보단 속도를 조금 포기하더라도 수정없이 가야겠다고 생각했습니다
일대다 조인에 따라 데이터 뻥튀기가 일어나서 groupby연산을 하는데 드는 비용을 줄였습니다.
keyword를 입력을 한 경우엔 keyword를 조인하고, 아닌 경우에는 keyword조인을 없앱니다
경우에따른 다른 sql을 작성해서 keyword를 지정해준 경우 해당 keyword에 해당하는 store만 조회해와서 데이터 뻥튀기가 안일어나게 합니다.
그러면 group by지정이 필요없게 됩니다.
orderby절에서 인덱스를 활용하지못해서 sort연산이 발생하는 비용
like_count, review_count, avg_review_rating 컬럼을 인덱스로 지정해주면 정렬과정이 추가로 들지 않게됩니다.
이렇게 문제를 해결했지만 where절에 orderby컬럼이 지정되지않아서 sort연산이 계속 수행될 수 있습니다. 그런 경우는 다음과같이 where절에 orderby컬럼을 추가해주면
sort연산이 없어지면서 0.14ms ->0.015ms정도로 10배정도의 성능향상이 있습니다. (나머지 조건에 대해 인덱스 적용이 가능해지니 성능향상이 크게 나타납니다.)
튜닝 후 SQL문
# 인덱스: `status`, `review_count`, `store_id`, `name`, `address`
EXPLAIN ANALYZE  SELECT
        store0_.status,
        store0_.name,
        store0_.address,
        category1_.name
    from
        store store0_
    inner join
        category category1_
            on store0_.category_id=category1_.category_id
    inner join
        store_keyword storekeywo2_
            on store0_.store_id=storekeywo2_.store_id
    inner join
        keyword keyword3_
            on storekeywo2_.keyword_id=keyword3_.keyword_id
    where
        store0_.review_count  >= 0 AND
        store0_.status='APPROVED'
        AND  store0_.name LIKE '가게%'
        AND keyword3_.name = '분위기 좋은'

ORDER BY store0_.review_count
   LIMIT 100
   OFFSET 8000
400MS -> 50MS
대략 8배 정도의 개선을 하였습니다
(no offset을 활용하면 35배정도의 성능향상이있긴 하지만 현재 프로젝트 요구사항엔 no-offset이 알맞지 않습니다)