

캐시는 기본적으로 느린 스토리지 엑세스를 줄여서 데이터 검색 성능을 높이는 데에 있습니다.
그래서 일반적으로 빠른 엑세스 속도를 가지는 인메모리 데이터베이스를 사용합니다
캐시를 도입하는 과정에서 생기는 의문점을 정리하고 캐시의 단점도 알아보도록 하겠습니다
캐시에 대한 이해
캐시의 필요성
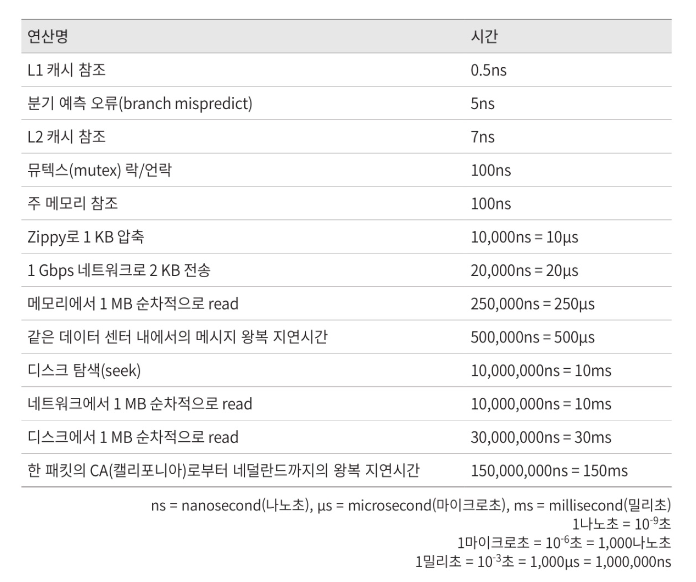
기본적으로 스토리지에 엑세스 하는 시간이 매우 오래 걸립니다.
메모리에 자주쓰이는 데이터를 저장함으로써 자주쓰이는 데이터는 캐시에서 찾아 응답속도를 향상시킵니다.
Long Tail 법칙은 20%의 요구가 시스템 리소스의 대부분을 사용한다는 법칙인데요, 그렇기 때문에 20%의 기능에 Cache를 이용함으로써 리소스 사용량은 대폭 줄이고, 성능은 대폭 향상시킬 수 있습니다,
아래 사진을 참고하면 디스크와 메모리의 속도차이에 대해서 대략적으로 알 수 있습니다.
캐시 적용시 고려사항
웹계층에서 상태정보를 제거한 웹 계층을 무상태 웹계층이라고 합니다.
(캐시 서버를 별도로 두는것을 말합니다)
기본적으로 스케일 아웃시 서버 각각은 세션 저장소를 독립적으로 갖게 돼서 정합성 문제가 발생합니다
이를 해결하기 위한 방식은 다음이 있습니다
- 고정세션방식
- 트래픽이 집중될수있습니다.
- 하나의 서버에 장애 발생하면 해당 서버 사용하는 사용자들 세션정보를 잃어버랍니다.
- 정합성 이슈를 해결할 수 있지만 스케일 아웃의 장점인 가용성과 트래픽분산이 제대로 안됩니다.
- 세션 클러스터링
- 정합성이슈해결, 가용성~트래픽분산까지 확보하는 방식입니다.
- all-to-all 세션 복제란 하나의 세션 저장소에 변경되는 요소가 발생하면 변경된 사항이 다른 모든 세션에 복제가 된다는 것을 말합니다
- Primary 서버는 Secondary(Backup) 서버에 세션 객체의 Key-Value 전체를 복제합니다.
- 하지만, 이외의 서버에는 Key에 해당하는 JSESSION ID만을 복제하기 때문에 메모리 사용이 all-to-all 방식보다 줄어들게 됩니다.
- all-to-all의 경우 하나의 세션 저장소에 변경이 일어나면 다른 모든 세션에 복제됩니다
- (많은 메모리필요, 서버수에 비례해서 네트워크 트래픽 증가 -> 소규모에서 좋은 효율)
- 그러니까 all-to-all은 스케일아웃에 한계가 존재합니다. 대규모에선 primary-secondary 방식을 사용합니다.
- primary 서버는 secoundary 서버의 전체를 복제하고 이외의 서버에는 key만 복제합니다
- -> 하지만 이 방식도 그리 빠르지 않습니다
- (primary, secondary를 제외한 proxy서버에 key에 해당하는 객체를 받아올때 많이 느립니다)
- 정합성이슈해결, 가용성~트래픽분산까지 확보하는 방식입니다.
- 세션 스토리지 분리
- 가용성측면: 서버하나에 장애가 발생해도 별도의 세션저장소가 존재해서 서비스 계속 이용가능합니다.
- 정합성문제: 로컬 세션 저장소의 불일치가 발생하지 않습니다
- 성능적문제: 세션 저장소가 하나여서 데이터 정합성 해결을 위한 별도의 세션 복제할 필요가 없어서 성능문제 해결 가능합니다
- 단, 세션 저장소도 해당 서버에 장애 발생하면 모든 세션 이용이 불가능해서 가용성을 확보하기 위해 세션 저장소를 하나 더 구성해야할 수 있습니다.
- 위와 같은 이유로 캐시 저장소를 별도의 서버로 분리하기로 결정하였습니다.
캐시 사용의 단점
데이터 정합성 문제
- 데이터베이스가 하나만 있다면 그곳에서 쓰기 읽기를 모두 처리하기 때문에 정합성문제가 발생하지 않습니다.
- 캐시가 도입될 경우 디비에 캐시된 데이터의 수정이나 삭제가 발생해도 캐시에는 변화가 없기 때문에
- 디비에 있는 실제 데이터와 캐시에 있는 데이터가 맞지 않아 문제가 생길 수 있습니다.
- 따라서 적절한 캐시 읽기 전략과 캐시 쓰기 전략을 통해, 캐시와 DB간의 데이터 불일치 문제를 극복하면서도 빠른 성능을 잃지 않게 해야합니다.
캐시 만료 시간을 설정해줘야하는 이유
캐시를 저장하는 곳은 무제한 저장소가 아닙니다. 따라서 적절한 만료시간을 설정해주어야합니다.
캐시가 많이 쌓이게 되면 그만큼 캐시 내부에서 데이터를 찾는 시간이 늘어나 오히려 속도가 느려집니다
또한 캐시에 데이터가 꽉 차게 되면 용량 부족 현상이 일어나 시스템이 다운 될 수 있습니다
캐시 만료 시간 설정
현재 제 프로젝트는 실사용자는 없으나 사용자가 많은 상황을 가정하고 진행을 하고 있습니다.
그렇기 때문에 적절한 모니터링하에 캐시 만료시간을 적절하게 설정하는데 어려움을 겪었습니다.
그렇기 때문에 캐시를 적용하는 API에 대해 다시 한번 생각해보고 적정해 보이는 캐시 만료시간을 설정하였습니다
3시간 정도의 캐시 만료 시간 설정 > 너무 긴 시간을 설정하여 캐시가 꽉 차는 현상을 막기 위함
수정/삭제 시에 캐시 비우기 > 가게 정보와 실제가 다른 점을 예방할 수 있음
캐시에 사용되는 데이터베이스 비교
Redis vs Memcached
- 캐시에 주로 사용하는 데이터베이스는 인메모리 데이터베이스인데요.
- 그 중에서 Redis와 Memcached가 많이 사용됩니다. 이 둘의 차이점을 알아봅시다
- Redis는 Memcached에 비해 다양한 자료구조를 지원하거나 다양한 캐시 삭제 방식을 지원합니다.
- 그 중에서 눈에 띄는 점은 Redis는 싱글스레드, Memcached는 멀티스레드를 지원한다는 점이었습니다.
- 싱글스레드: 연산량이 많은 작업을 하는 경우 그 작업이 완료되어야 다른 작업을 수행할 수 있다는 단점을 가지고 있습니다.
업데이트 및 유지 보수의 복잡성: 싱글 스레드 환경에서 캐시 전략이나 데이터 구조를 변경하려면 해당 스레드를 중지해야 할 수도 있습니다. 이는 서비스 중단을 초래할 수 있습니다. - 멀티스레드: context switching, 동기화 등의 이유 때문에 싱글 코어 멀티 스레딩은 스레드 생성 시간이 오히려 오버헤드로 작용해 단일 스레드보다 느립니다.
공유하는 자원(데이터, 힙 영역)에 동시에 접근하는 경우에 대한 처리가 추가적으로 필요합니다
멀티코어 멀티스레딩의 경우 자원을 효율적으로 활용하여 응답성이 좋습니다.
- 싱글스레드: 연산량이 많은 작업을 하는 경우 그 작업이 완료되어야 다른 작업을 수행할 수 있다는 단점을 가지고 있습니다.
Redis와 Memcached의 성능비교
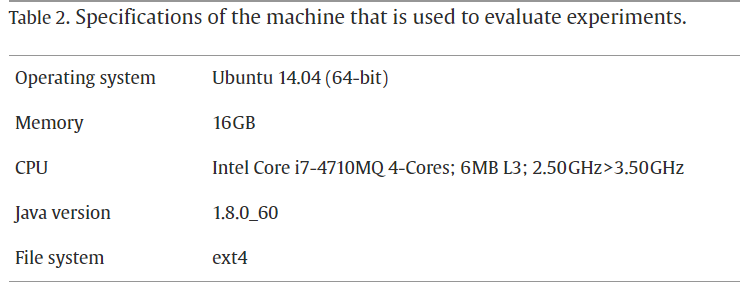
- 위와 같이 4개의 코어를 가진 환경에서 성능을 비교해봅니다.
- 이론에서와는 달리 멀티 코어를 가진 상황에서도 작은 차이지만 Redis가 읽기가 더 빠른것을 볼 수 있었습니다.
- 하지만 write에서는 read보다 더 많은 차이로 Memcache가 빠른 응답 시간을 보였습니다.
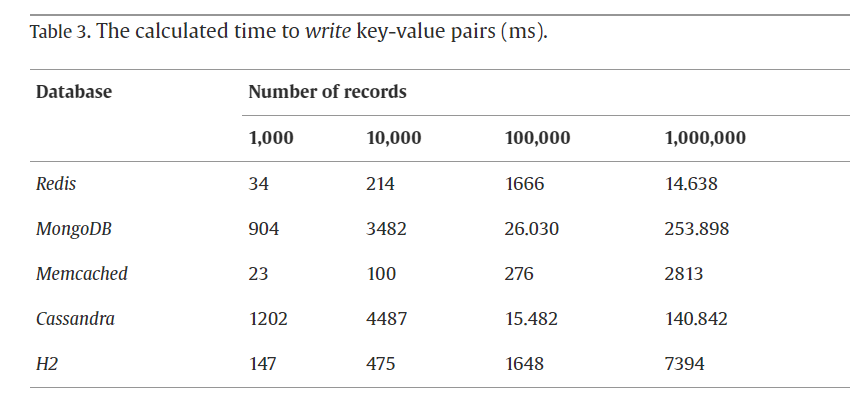
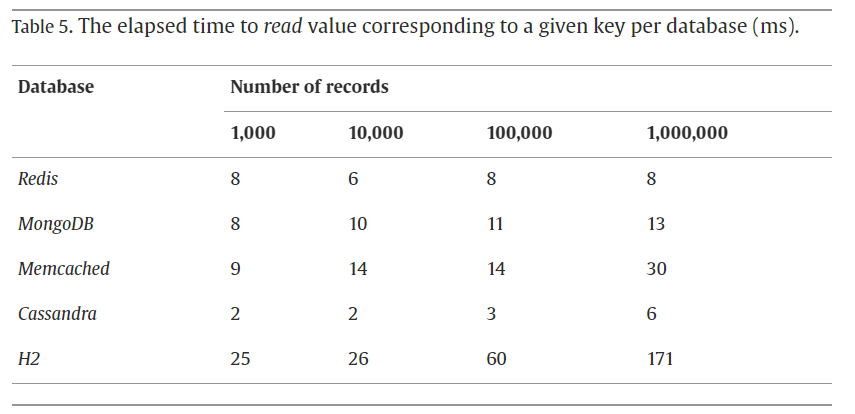
- 현재 캐시 서버는 싱글코어에서 돌아가고 있습니다.
- 이 점을 감안해서 조금 더 성능상의 이점이 있을 것으로 예상되고, 다양한 삭제 방식을 지원하는 Redis를 사용하기로 결정하였습니다
Lettuce 선정 이유
- Redis 클라이언트에는 Lettuce와 Jedis가 있습니다
- Lettuce: thread-safe한 Redis 클라이언트으로, Redis와 상호작용하기 위한 API를 제공합니다 (동기, 비동기 지원)
- 사용성이 어렵다
- 비동기로 처리해서 고성능을 낼 수 있음
- Jedis
- 동기 방식으로 작동하여 Blocking 이슈가 발생 가능
- 기본적으로 단일스레드지만 JedisPool을 사용하면 여러 스레드에서 redis와 소통할 수 있습니다.
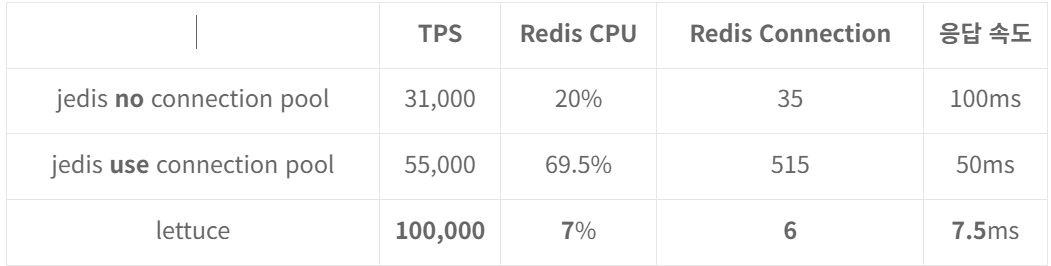
- 위의 표를 보시면 성능 측면에서 Lettuce가 우위에 있는 것을 확인할 수 있습니다
Lettuce vs Jedis 실제 성능 테스트
프로젝트에서 Lettuce를 적용했을때와 Jedis(no connection pool)를 적용했을때의 성능을 비교해보겠습니다
package com.twogather.twogatherwebbackend.config;

@Configuration
public class RedisConfig {

    @Value("${spring.redis.session.host}")
    private String hostName;

    @Value("${spring.redis.session.port}")
    private int port;


    @Bean
    RedisConnectionFactory redisConnectionFactory() {

        RedisStandaloneConfiguration redisStandaloneConfiguration = new RedisStandaloneConfiguration();
        redisStandaloneConfiguration.setHostName(hostName);
        redisStandaloneConfiguration.setPort(port);
        LettuceConnectionFactory lettuceConnectionFactory = new LettuceConnectionFactory(redisStandaloneConfiguration);
        return lettuceConnectionFactory;
    }
    /*
    @Bean
    RedisConnectionFactory redisConnectionFactory() {
        return new LettuceConnectionFactory(hostName, port);
    }*/
    @Bean
    RedisTemplate<String, Object> redisTemplate() {

        RedisTemplate<String, Object> redisTemplate = new RedisTemplate<>();
        redisTemplate.setConnectionFactory(redisConnectionFactory());
        redisTemplate.setKeySerializer(new StringRedisSerializer());
        redisTemplate.setValueSerializer(new GenericJackson2JsonRedisSerializer());
        redisTemplate.setDefaultSerializer(new GenericJackson2JsonRedisSerializer());

        return redisTemplate;
    }
}
agent: 1
process: 10
Threads: 20
duration: 2분
서버 구성: t3.micro
CPU: vCPU 1개
메모리: 1GB
EBS 전용 스토리지(로컬 SSD 스토리지 없음)
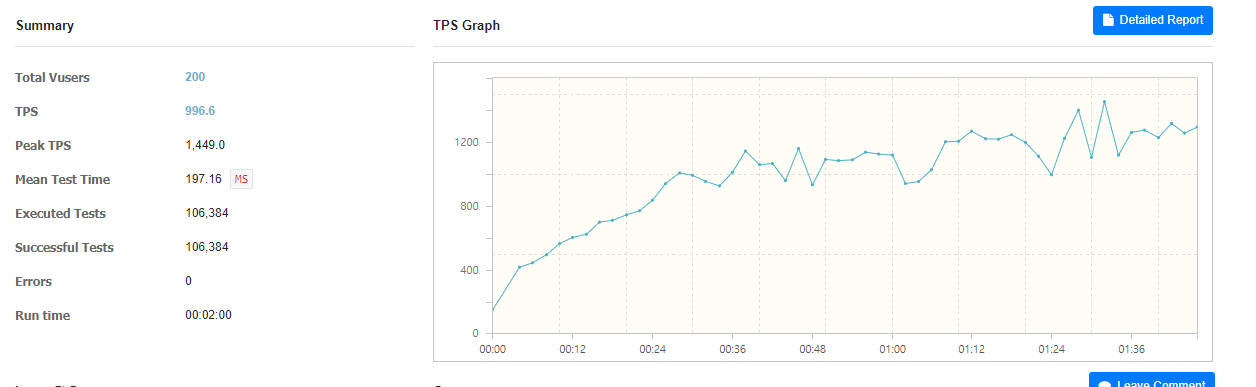
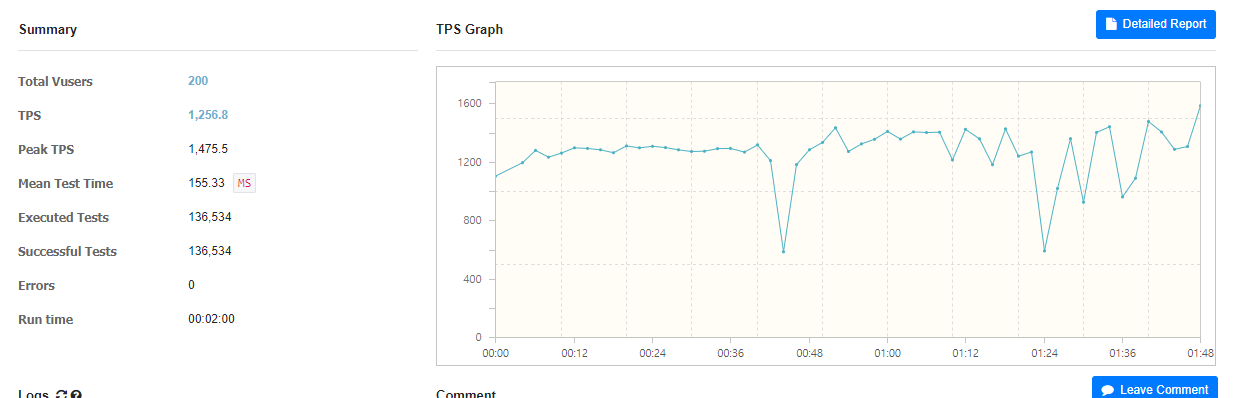
제 프로젝트에서도 Lettuce 사용 시 큰 차이는 아니지만 더 적은 응답시간을 보이는 것을 확인할 수 있었습니다
레디스(Redis)는 주요 작업을 처리하는 부분이 싱글 스레드 기반으로 동작합니다. 이러한 싱글 스레드 특성
때문에 다중 커넥션으로 여러 요청이 동시에 레디스 서버에 도착하더라도, 실제로 그 요청들은 순차적으로 한 번에 하나씩 처리됩니다. 즉, 동시에 여러 작업을 병렬로 처리할 수 없기 때문에 다중 커넥션의 이점이 크게 발휘되지 않습니다. 만약 레디스가 멀티 스레드로 동작하면, 다중 커넥션을 사용하여 동시에 여러 요청을 병렬로 처리할 수 있을 것입니다. 하지만 싱글 스레드 기반인 현재의 레디스에서는 그렇지 않습니다.
캐시 적용
어떤 API에 캐시를 적용할 것인가?
TopN 가게 불러오기 API- 홈페이지에 처음 들어오면 TOP10가게에 대한 정보를 불러옵니다.
- 홈페이지의 경우 여러 end point중 높은 트래픽이 예상되며 가게를 불러올때 사용되는 쿼리가 복잡하기 때문에 응답시간도 꽤 걸릴것으로 예상이됩니다. 또한 자주 변경이 되지않는다는 특징을 가지고 있습니다.
- 그래서 해당 API에 캐싱을 적용하기로 결정하였습니다
캐시 도입 후
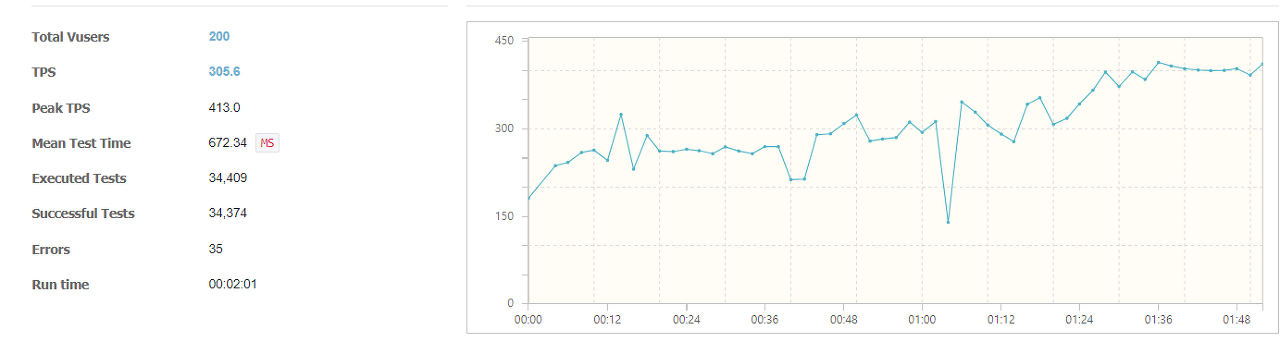
- 먼저 nGrinder를 사용하여 TopN 가게 불러오기 API에 대해 성능 테스트를 해봅니다.
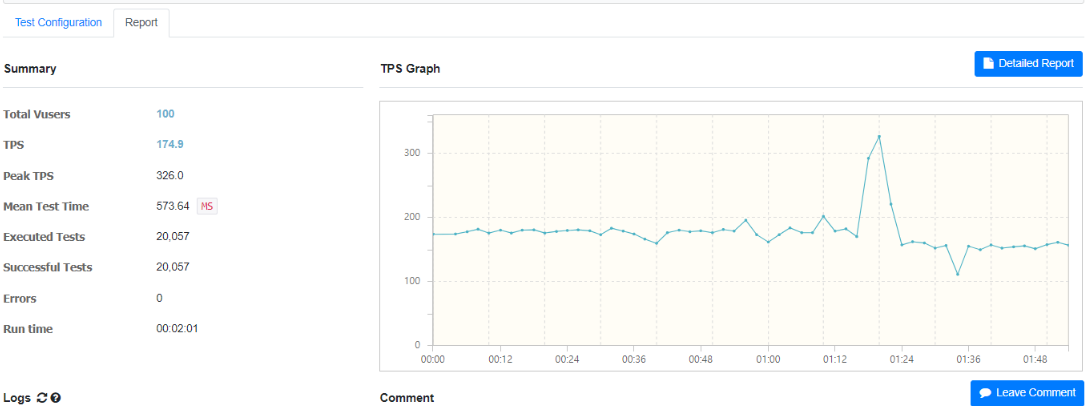
- 100명으로는 에러율도 적고 테스트 평균 수행시간초 1초이내로 괜찮습니다.
- 200명으로 늘려서 테스트를 진행해보겠습니다.
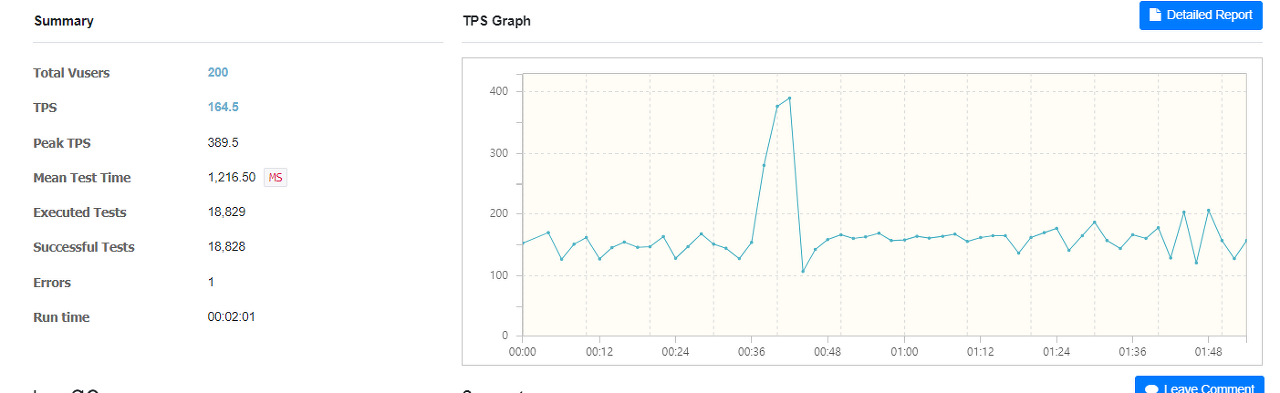
- 에러율은 2만건 중에 1회정도로 적은 반편 수행시간은 1초를 넘어가고 있습니다.
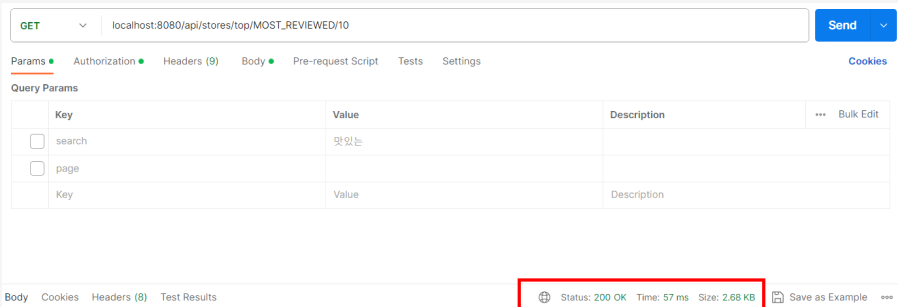
- Postman으로 TOPN개의 가게를 가져오는 기능을 테스트를 해보았습니다.
- 캐싱 적용 후에 응답 시간이 57ms -> 5ms로 변화하였습니다.
-
-
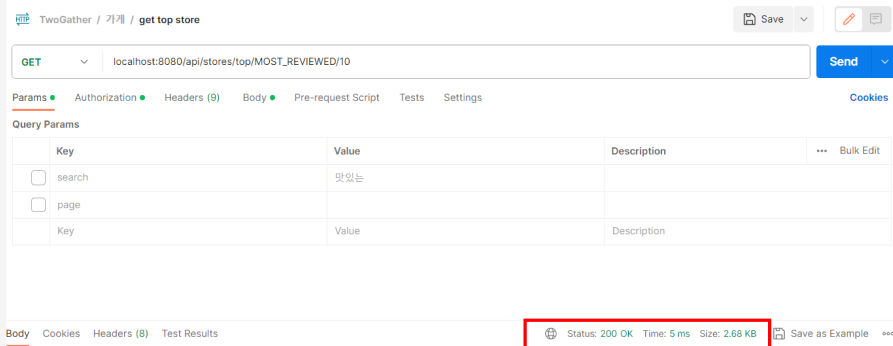
- 캐싱이란 이전 요청을 기억하는 기능이기 때문에 첫 요청으로는 성능 최적화가 되지 않습니다.
- 그렇기때문에 첫번째 요청이 아닌 요청으로 성능비교를 합니다.
- 또한 첫 번째 요청에는 일반적인 프로세스의 일부가 아닌 일부 추가 작업(ex: 데이터베이스 연결 및 캐시에 데이터 저장)이 포함되는데요.
- 성능 측정은 시스템이 보통의 상태에서 작동할때 계산하는 것이 더 의미가 있습니다. (이러한 값이 일반적인 사용자 경험을 나타내기 때문입니다.)
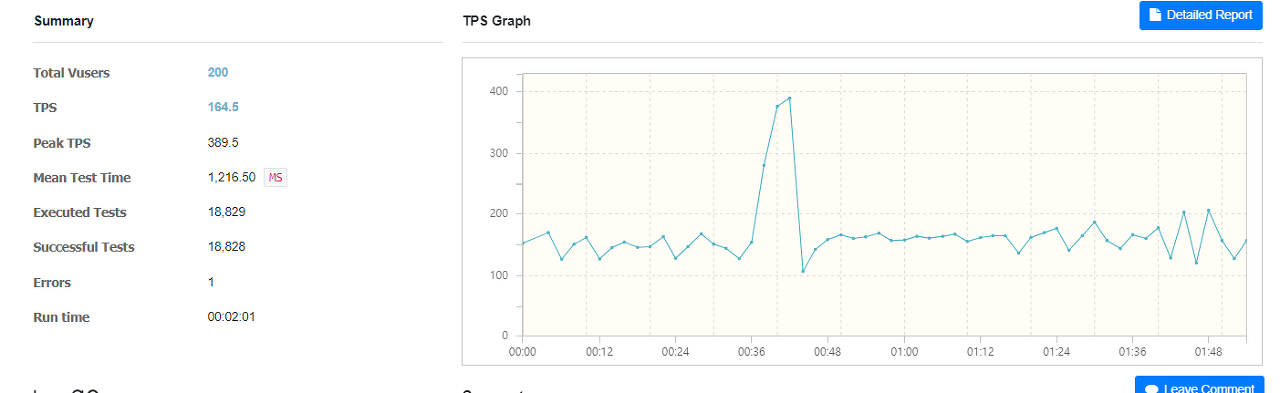
nGrinder 결과 비교
https://www.baeldung.com/java-redis-lettuce
https://jronin.tistory.com/126
https://hyuntaeknote.tistory.com/6
캐시(Cache) 설계 전략 지침
'데이터베이스' 카테고리의 다른 글
| 커밋이 완료되었다고 정말 디스크에 적혔을까? (1) (0) | 2026.02.22 |
|---|---|
| PostgreSQL MVCC와 VACUUM: Index Bloat (0) | 2026.02.21 |
| 쿼리 튜닝으로 getConnection()의 긴 응답시간 해결 (0) | 2023.09.19 |
| 동시성 문제의 다양한 해결법(이론) (0) | 2023.09.08 |
| 쿼리 성능 개선 (0) | 2023.09.05 |