

HTTP/1.1에서 헤드오브라인 블로킹 문제가 있었고, HTTP/2에서는 이를 해결했다는 글을 읽었습니다. 그런데 문득 HTTP/1.1에선 멀티플렉싱을 쓰고 싶어도 못쓰는걸까? 하는 생각이 들었습니다. 더 깊이 이해하고 싶어서 관련 내용을 찾아보았습니다
멀티플렉싱이란?
- 하나의 connection 으로 동시에 여러개의 메세지 스트림을 주고 받는 것
- http 2에서 도입됨
프레임, 메세지, 스트림
- Frame : 요청1은 여러 프레임으로 쪼개질 수 있으며, 메타정보를 담는 헤더프레임, 실제 컨텐츠를 담는 데이터프레임 이렇게 두종류의 프레임이 존재합니다
- Message : 요청1,응답1 각각을 메세지라는 단위로 봅니다
- Stream : 요청1, 응답1 쌍을 하나의 스트림으로 봅니다
- Connection: 하나의 커넥션에 여러 스트림이 속합니다
- -> 요청 하나에 여러 Frame이 속하고 각각의 요청-응답은 Message가 되고, 요청-응답쌍을 하나의 Stream이라고 칭하며 여러 스트림이 하나의 커넥션에 속합니다
HTTP/1.1에서의 처리
- http 1.1에서는 하나의 연결만 사용해서 여러 리소스를 보내야할때, 어떻게 처리했을까요?
- http1.1에서 connection이 한개고 요청을 3개 처리해야하면
- a요청 → a응답 → b 요청 → b응답 → c요청 → c응답
- 과같은 순서대로 도착 해야합니다. (즉, 먼저 보낸 요청은 먼저 응답이 와야한다)
- 그래서 중간에 있는 요청 b의응답이 느려지면 그 다음 c요청이 지연됩니다 (헤드오브라인 블로킹)
- 그래서 http2에선 요청 순서에 상관없이 처리가능하게 바뀌었습니다
HTTP/1.1에선 멀티플렉싱을 쓰고 싶어도 못쓰는걸까?
- stream id가 http1.1에 없기 때문에 멀티플렉싱을 쓰고싶어도 사용할 수 없습니다. (어떤 요청에 대한 데이터인지 구분을 못하기 때문이다)
- 예를들어 같은 커넥션인데, 요청 a, b, c를 섞어서 나눠서 보내면 어떤데이터가 a인지 b인지를 알 수 없습니다. 이를 구분하는 데이터가 stream id입니다. 하지만, 네트워크 탭에서 stream id라는 데이터를 실제로 본적이 없었습니다. 왜냐하면 http 일반 헤더가 아니라 프레임 헤더에 정보가 존재하기 때문입니다. 따라서 네트워크 탭이 아닌 wireshark를 통해 패킷을 분석해봤습니다.
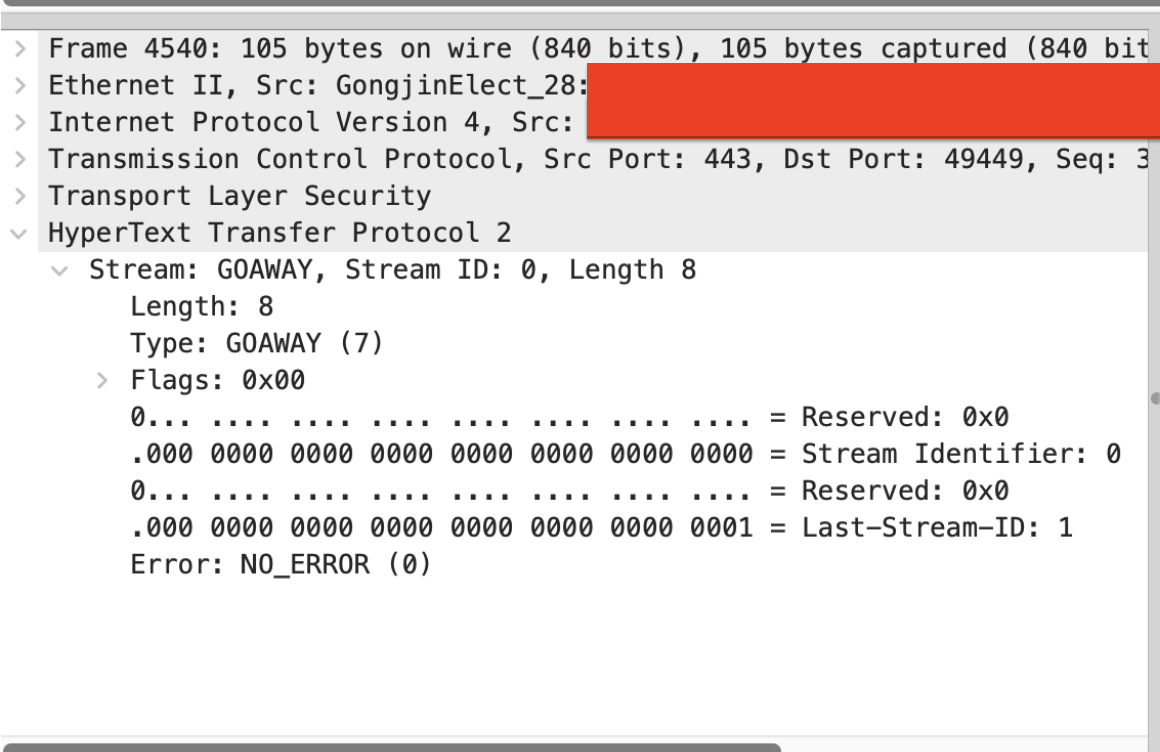
- http2만으로 wireshark필터링을 하려는데 잘 안돼서, 링크 참고
- http2.streamid==21 와 같이 특정 stream id 로 필터링을 해보면 같은 stream id를 가진 여러 요청들을 필터링해서 볼 수 있습니다.
프레임헤더와 일반 HTTP 헤더의 차이
HTTP/2는 기존의 텍스트 기반 HTTP와 달리 바이너리 프로토콜로 동작합니다. 즉, 데이터가 사람이 읽기 쉬운 텍스트가 아니라, 여러 개의 프레임(frame)으로 분할되어 전송됩니다. 이 프레임들은 모두 자체 헤더를 가지고 있으며, 그 중 하나가 stream id입니다
HTTP/1.1의 청크 인코딩과 HTTP/2의 프레임 기반 전송의 차이
"HTTP/1.1은 서버가 전체 응답의 크기를 미리 알 수 없을 때, 응답을 일정 크기의 청크 단위로 나눠 전송합니다. 그런데 청크 전송 인코딩은 텍스트 기반이라 파싱에 추가적인 부담(파싱 오버헤드)이 있습니다." 라는 문장을 읽고 두가지 의문이 들었습니다.
- 텍스트 기반 (사람이 읽기쉬운 데이터)면 왜 파싱 오버헤드가 있는것인가?
- 파싱 오버헤드가 어떤 문제이길래 사람이 읽기 쉽다는 장점을 버릴 정도인 것인가?
- 텍스트 기반: "apple,banana,orange"라는 데이터를 보낸다고 가정하고, 컴퓨터는 데이터를 특정 문자열로 나눈다고 가정합니다. 하지만 항상 이런 방법에는 특정문자열이 데이터내에 포함되는 경우를 생각해야만합니다. 즉, 텍스트 기반에서는 항상 예상하지 못한 경우를 처리하는 추가 로직을 만들어야 하고, 오류가 발생할 가능성이 높아집니다.
- 바이너리 기반 포맷에서는 데이터의 각 부분이 정확한 위치와 길이를 가집니다. 예를 들어, 첫 번째 4바이트는 무조건 데이터 길이, 그 다음 1바이트는 타입이라고 정해져 있다면, 컴퓨터는 데이터를 읽을 때 "정확히 4바이트 읽고, 다음 1바이트 읽는다"는 방식으로 데이터를 읽을 수 있기 때문에 텍스트기반에서의 문제가 자연스럽게 사라집니다.
벤치마킹 테스트
파싱 오버헤드에 따른 성능 차이를 보다 명확하게 이해하기 위해 HTTP/1.1의 청크 인코딩과 HTTP/2의 바이너리 프레임 기반 전송 방식을 비교하는 벤치마킹 테스트를 수행해보았습니다. 각각의 방식을 자바로 구현하여 실행 시간을 측정하였으며, 벤치마크에 사용된 코드는 다음과 같습니다.
package com.benchmark;

import org.openjdk.jmh.annotations.*;

import java.io.BufferedReader;
import java.io.ByteArrayInputStream;
import java.io.IOException;
import java.io.InputStreamReader;
import java.nio.ByteBuffer;
import java.nio.charset.StandardCharsets;
import java.util.concurrent.TimeUnit;

@BenchmarkMode(Mode.AverageTime)       // 평균 실행 시간을 측정
@OutputTimeUnit(TimeUnit.NANOSECONDS)    // 결과를 나노초 단위로 출력
@State(Scope.Benchmark)                  // 벤치마크 전역 상태로 사용
public class Test1 {

    // HTTP/1.1의 청크 인코딩 응답 예제:
    // HTTP/1.1은 텍스트 기반 프로토콜이며, 데이터를 청크 단위로 전송합니다.
    // 예제 문자열은 각 청크의 크기를 16진수로 표현한 후, CRLF로 구분되고, 0 청크로 종료됩니다.
    // 예: "4\r\nWiki\r\n5\r\npedia\r\n0\r\n\r\n"
    private byte[] http1ChunkedResponse;

    // HTTP/2 프레임 응답 예제:
    // HTTP/2는 바이너리 프로토콜로, 데이터를 '프레임' 단위로 전송합니다.
    // 프레임 헤더는 9바이트로 구성되며, 그 뒤에 실제 데이터(payload)가 이어집니다.
    // 아래 예제에서는 9바이트 헤더와 10바이트의 payload를 포함하는 배열을 만듭니다.
    private byte[] http2FrameResponse;

    @Setup(Level.Trial)
    public void setup() {
        // --- HTTP/1.1 청크 인코딩 데이터 준비 ---
        // 이 문자열은 두 개의 청크("Wiki", "pedia")와 0 크기의 청크로 종료됨을 나타냅니다.
        // 특정 문자열 (\r\n)을 기준으로 데이터를 나눌수있고 첫번째는 크기 두번쨰는 데이터를 의미합니다
        // "4" -> 첫 청크의 크기(4바이트), "Wiki" -> 첫 번째 청크 데이터
        // "5" -> 두 번째 청크의 크기(5바이트), "pedia" -> 두 번째 청크 데이터
        // "0" -> 청크 종료를 의미
        http1ChunkedResponse = "4\r\nWiki\r\n5\r\npedia\r\n0\r\n\r\n".getBytes(StandardCharsets.US_ASCII);

        // --- HTTP/2 프레임 데이터 준비 ---
        // HTTP/2 프레임 구조:
        // - 3바이트: Payload의 길이 (big-endian)
        // - 1바이트: 프레임 타입 (예: 0x01 = HEADERS 프레임)
        // - 1바이트: 플래그 (예: 0x04 = END_HEADERS)
        // - 4바이트: 스트림 식별자 (최상위 비트는 예약되어 있으므로 마스킹)
        // - 그 뒤: Payload 데이터 (여기서는 10바이트의 임의 값)
        ByteBuffer buffer = ByteBuffer.allocate(9 + 10); // 헤더 9바이트 + payload 10바이트
        // 3바이트 길이: 10을 16진수 0x00000A로 표현 (payload 길이)
        buffer.put((byte) 0x00);
        buffer.put((byte) 0x00);
        buffer.put((byte) 0x0A);
        // 1바이트 타입: 0x01 (예시로 HEADERS 프레임 사용)
        buffer.put((byte) 0x01);
        // 1바이트 플래그: 0x04 (예시로 END_HEADERS 플래그)
        buffer.put((byte) 0x04);
        // 4바이트 스트림 식별자: 여기서는 스트림 번호 1 (예약 비트를 제거하기 위해 & 0x7FFFFFFF)
        buffer.putInt(1);
        // Payload: 10바이트의 임의 값 (여기서는 1부터 10까지의 바이트)
        for (int i = 0; i < 10; i++) {
            buffer.put((byte) (i + 1));
        }
        http2FrameResponse = buffer.array();
    }

    /**
     * HTTP/1.1 청크 인코딩 응답을 파싱하는 벤치마크 메서드.
     *
     * 이 메서드는 HTTP/1.1에서 청크 전송 인코딩된 응답을 읽어서,
     * 각 청크의 크기를 파싱한 후 해당 크기만큼 데이터를 읽어 누적합니다.
     * 최종적으로 누적한 문자열의 길이를 반환합니다.
     *
     * 네트워크 지연은 없으며, 단순히 CPU가 텍스트를 파싱하는 오버헤드를 측정합니다.
     */
    @Benchmark
    public int parseHttp1Chunked() {
        // ByteArrayInputStream을 이용하여 바이트 배열을 InputStream으로 변환합니다.
        ByteArrayInputStream bis = new ByteArrayInputStream(http1ChunkedResponse);
        // BufferedReader를 통해 텍스트 데이터를 읽습니다.
        BufferedReader reader = new BufferedReader(new InputStreamReader(bis, StandardCharsets.US_ASCII));
        StringBuilder sb = new StringBuilder();
        try {
            String line;
            // 응답의 각 줄을 순차적으로 읽습니다.
            while ((line = reader.readLine()) != null) {
                // 각 청크의 시작 줄은 청크의 크기를 16진수 문자열로 나타냅니다.
                int chunkSize;
                try {
                    chunkSize = Integer.parseInt(line.trim(), 16);
                } catch (NumberFormatException e) {
                    break;  // 파싱 실패 시 종료
                }
                // 청크 크기가 0이면 응답이 종료됨을 의미합니다.
                if (chunkSize == 0) {
                    break;
                }
                // 지정된 크기만큼의 문자 데이터를 읽어 청크 데이터를 가져옵니다.
                char[] chunk = new char[chunkSize];
                int read = reader.read(chunk, 0, chunkSize);
                sb.append(chunk, 0, read);
                // 각 청크 뒤에는 CRLF (줄바꿈)이 있으므로, 한 줄을 추가로 읽어 버립니다.
                reader.readLine();
            }
        } catch (IOException e) {
            // 실제 벤치마크 환경에서는 예외가 발생하지 않는다고 가정합니다.
            e.printStackTrace();
        }
        // 최종 누적한 문자열의 길이를 반환합니다.
        return sb.length();
    }

    /**
     * HTTP/2 프레임 응답을 파싱하는 벤치마크 메서드.
     *
     * 이 메서드는 HTTP/2의 프레임 구조를 모방한 바이트 배열을
     * ByteBuffer로 감싸고, 프레임 헤더(길이, 타입, 플래그, 스트림 id)를 파싱한 후,
     * payload 부분의 바이트들을 단순히 합산(sum)을 계산합니다.
     *
     * 이를 통해 HTTP/2의 이진 프레이밍 방식으로 데이터를 파싱할 때의 CPU 소비를 측정합니다.
     */
    @Benchmark
    public int parseHttp2Frame() {
        // ByteBuffer를 이용하여 HTTP/2 프레임 응답을 읽습니다.
        ByteBuffer buffer = ByteBuffer.wrap(http2FrameResponse);
        // --- 프레임 헤더 파싱 ---
        // 3바이트: payload 길이 (big-endian)
        // buffer.get()은 1바이트(8비트)를 읽습니다.
        // 1. Java의 byte는 -128 ~ 127 범위를 가짐 (8비트 signed integer)
        // 2. 128(0x80) 이상 값이 들어오면 음수로 변환됨 (2의 보수 방식)
        // 3. 129 이상의 값이 원래 무엇이었는지 알고 싶다면 & 0xFF 사용
        // 4. buffer.get() & 0xFF를 하면 원래 부호 없는 값(0~255)을 얻을 수 있음
        int length = ((buffer.get() & 0xFF) << 16)
                | ((buffer.get() & 0xFF) << 8)
                | (buffer.get() & 0xFF);
        // 1바이트: 프레임 타입 (여기서는 단순 예제이므로 사용하지 않음)
        byte type = buffer.get();
        // 1바이트: 플래그 (여기도 예제용)
        byte flags = buffer.get();
        // 4바이트: 스트림 식별자 (최상위 예약 비트 제거)
        int streamId = buffer.getInt() & 0x7FFFFFFF;
        // --- Payload 파싱 ---
        // payload의 각 바이트를 읽어 단순 합(sum)을 계산합니다.
        int sum = 0;
        for (int i = 0; i < length; i++) {
            sum += (buffer.get() & 0xFF);
        }
        return sum;
    }

    // main 메서드를 통해 JMH 벤치마크 실행기를 호출할 수 있습니다.
    public static void main(String[] args) throws Exception {
        org.openjdk.jmh.Main.main(args);
    }
}- parseHttp1Chunked():
- HTTP/1.1의 텍스트 기반 청크 인코딩을 모방하여, 입력 스트림에서 각 줄을 읽고,
- 첫 줄에서 청크 크기를 파싱한 후 해당 크기만큼 데이터를 읽어 누적하는 방식으로 파싱합니다.
- 최종적으로 누적된 문자열의 길이를 반환하여 파싱 작업의 CPU 소비를 측정합니다.
- parseHttp2Frame():
- HTTP/2의 바이너리 프레임 구조를 모방하여, ByteBuffer를 통해 9바이트의 헤더를 읽고,
- 헤더에서 payload 길이를 구한 뒤, 그 길이만큼의 데이터를 순차적으로 읽어 바이트들의 합을 계산합니다.
- 이 역시 네트워크 지연 없이 파싱에 소요되는 CPU 시간만 측정하는 예제입니다
Benchmark                Mode  Cnt    Score    Error  Units
Test1.parseHttp1Chunked  avgt   25  725.497 ± 12.011  ns/op
Test1.parseHttp2Frame avgt 25 3.358 ± 0.045 ns/op- Score: 한 번의 메서드 실행(또는 "operation")에 걸리는 평균 시간입니다. (CPU에서 이 작업을 처리하는 데 소요된 시간)
- Mode (avgt): 평균 시간을 측정한다는 의미입니다.
- ns/op: 단위가 나노초입니다.
파싱 오버헤드에 따른 벤치마크 결과를 비교하면, HTTP/1.1의 청크 인코딩 방식은 평균 실행시간이 725.497ns인 반면, HTTP/2의 바이너리 프레임 기반 방식은 약 3.358ns로 약 250배 정도의 차이가 났습니다. 이는 텍스트 기반으로 데이터를 주고받는 HTTP/1.1이 바이너리 데이터를 사용하는 HTTP/2에 비해 파싱할 때 더 많은 CPU 자원을 소비하기 때문입니다. 텍스트 기반 방식에서는 문자열 해석 과정에서 추가적인 연산이 필요하지만, 바이너리 방식은 데이터의 구조가 미리 정의되어 있어 바로 파싱할 수 있기 때문입니다. 즉, HTTP/2는 데이터 처리 과정에서의 파싱 오버헤드를 최소화하여 효율적으로 멀티플렉싱을 지원할 수 있습니다.
'네트워크' 카테고리의 다른 글
| 프로세스가 죽어도 FIN이 전송된다 (0) | 2026.07.16 |
|---|