

지난 시간 nGrinder를 사용하여 성능 테스트를 진행하였습니다. 하지만 error에 따른 서버 로그는 확인하기가 어려웠기 때문에 추가적인 tool(pinpoint)를 사용하여 오류를 검출해보고 해결해보는 시간을 가지고자 합니다.
인코딩 문제
postman을 활용하여 테스트할 시에는 인코딩에 문제가 있지 않았는데 nGrinder를 사용하고 트래픽을 보낼때는 요청 전부가 실패하는 현상이 있었습니다. 해당 요청의 오류 로그를 확인해 본 결과 다음과 같은 정보가 담겨있었습니다.
Invalid UTF-8 start byte 0xbb at [Source: (org.springframework.util.StreamUtils$NonClosingInputStream); line: 3, column: 15] (through reference chain: com.twogather.twogatherwebbackend.dto.member.FindUsernameRequest["name"])
nGrinder 실행 시 script
    @Test
    public void test() {
        HTTPResponse response = request.POST("http://3.38.105.8:8080/api/members/my-id", body.getBytes())//주목

        if (response.statusCode == 301 || response.statusCode == 302) {
            grinder.logger.warn("Warning. The response may not be correct. The response code was {}.", response.statusCode)
        } else {
            assertThat(response.statusCode, is(200))
        }
    }
첫번째 줄의 body.getBytes()는 시스템의 기본 문자셋을 사용하여 바이트 배열로 변환하게 됩니다. 만약 시스템의 기본 문자셋이 UTF-8이 아니라면, 이 부분에서 문제가 발생할 수 있습니다.
body.getBytes()를 body.getBytes("UTF-8")로 변경하여 UTF-8로 명시적으로 인코딩하여 문제를 해결하였습니다
getConnection()의 긴 응답시간
지난 번 쿼리 튜닝을 진행했던 Search API의 수행시간이 높은 트래픽에서 8초를 넘어가는 문제가 발생했습니다. (트래픽 안 몰릴 시 100ms)
이로 인해 사용자 경험이 저하되며, 트래픽이 몰릴 때 서비스의 안정성에도 문제가 발생할 수 있습니다.
이는 팀의 핵심 비즈니스 목표인 '빠르고 안정적인 서비스 제공'에 직접적인 영향을 미칩니다.
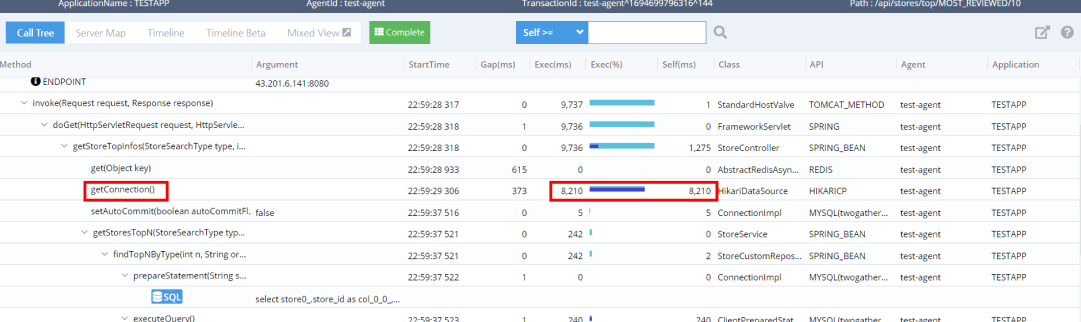
- 먼저 pinpoint의 결과에 따르면 시간중 많은 시간이 getConnection()하는데에 걸리고 있었습니다.
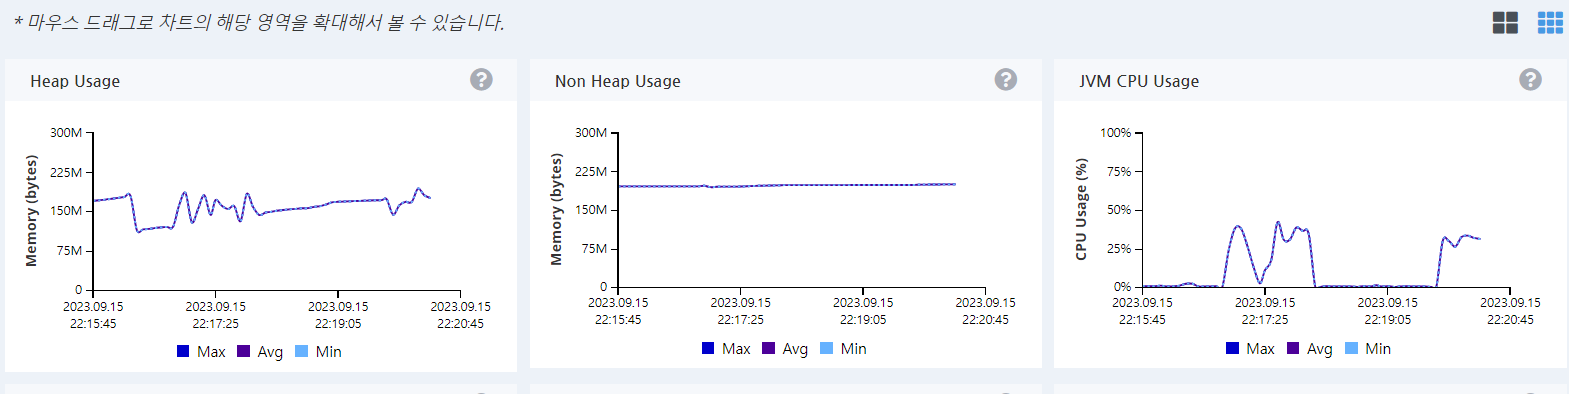
- 다음으로 자원 사용량에 대해서 확인을 해보면, 현재 인스턴스는 1GB 메모리를 사용하고 있어서 1/5정도 해당하는 메모리를 사용하는것이 큰 문제가 되지 않을 것이라고 판단하였습니다.
- CPU 사용량 또한 최대 50% 이하 정도를 사용하고 있어서 문제가 될 것 같지는 않습니다.
이유
getConnection()의 수행시간이 오래걸리는 이유에는 다음과 같은 것들이 있습니다
- 잘못된 Connection Pool size 설정
- DB Connection Pool은 여러 개의 데이터베이스 연결을 미리 만들어놓고, 필요할 때 그 연결을 제공하고, 사용이 끝나면 다시 연결 풀에 반환하는 방식입니다. 이를 통해 연결을 빠르게 재사용할 수 있어 시스템의 성능이 향상됩니다.
- 하지만 동시에 많은 사용자나 작업이 데이터베이스에 접근하려고 할 때, 너무 적은 연결 수를 사용하게 된다면 모든 연결이 사용 중이여서 새로운 요청은 대기 상태가 될 수 있습니다. 이로 인해 시스템의 전체적인 처리 능력이 떨어질 수 있습니다
- 서버 과부하
- CPU, 메모리 등의 과부하로 다른 작업을 처리하느라 getConnection()의 처리 시간이 늦어질 수 있습니다.
- 데이터베이스 서버와 프로젝트 서버 모두 CPU사용률이 50% 이하로 사용이 되고 있었기에 서버 과부하에 의한 지연은 아니라고 판단하였습니다
- 쿼리 개선
connection pool size 조정
spring.datasource.hikari.minimum-idle=7
spring.datasource.hikari.maximum-pool-size=30
spring.datasource.hikari.idle-timeout=600000
spring.datasource.hikari.pool-name=HikariPool-1
spring.datasource.hikari.max-lifetime=1800000
spring.datasource.hikari.connection-timeout=10000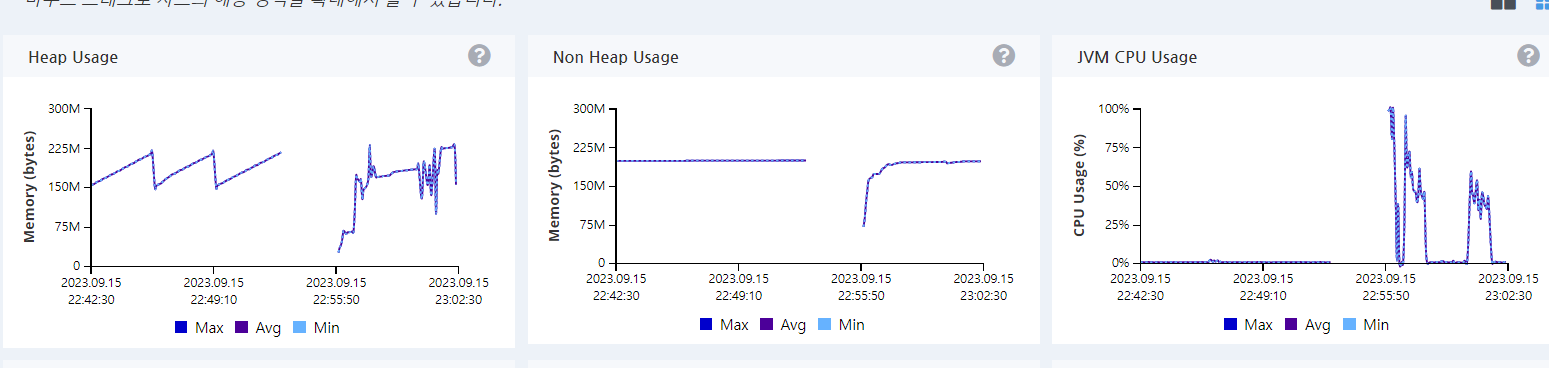
- connection pool 의 size를 증가시키자 첫번째 테스트에선 CPU의 사용률이 100%에 가까워지는 현상이 발생하였습니다
- 하지만 CPU사용률이 높지 않았던 두번째 테스트에서도 getConnection()의 지연시간은 계속 길었고, connection size를 변경하기 이전과의 응답속도가 크게 다르지 않았습니다.
nGrinder를 사용한 성능테스트 결과
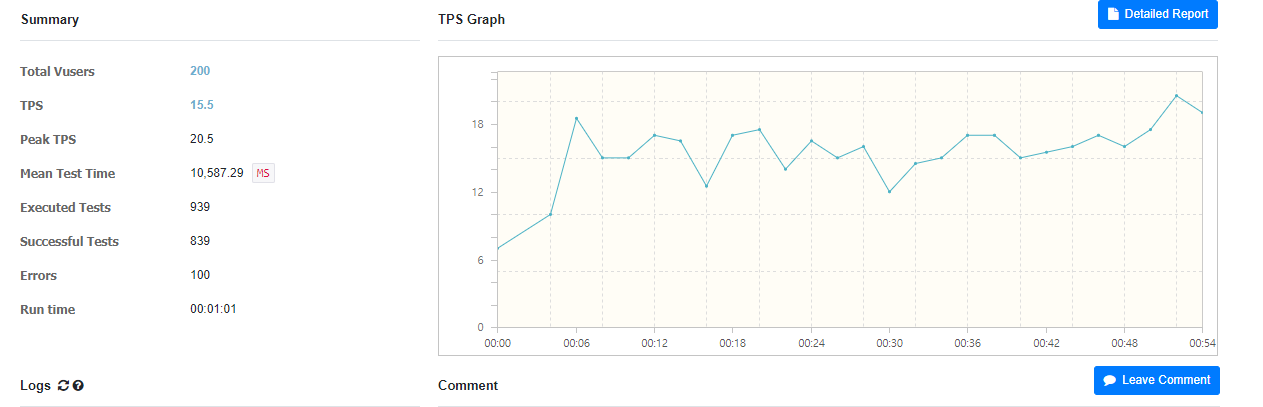
테스트 수행시간은 10초를 넘어가는데 실제 수행된 테스트는 매우 적음을 확인할 수 있었습니다.
그럼에도 불구하고 데이터베이스의 큰 부하가 걸리는것이 의문이었습니다.
CPU 활용률이 서버에 미치는 영향
- JVM CPU 사용률이 100% 란 말이 무조건 JVM만 CPU를 독점하고 있고, 다른 작업은 처리하고 있지 못하다는 말은 아닙니다.
- JVM의 CPU 사용률이 100%라는 것은 JVM 프로세스가 현재 할당받은 CPU 코어 또는 코어들에서 최대한 많은 CPU 시간을 사용하고 있다는 것을 의미합니다.
- 다시 말해, 시스템에 여러 CPU 코어가 있을 때, 특정 JVM 프로세스의 CPU 사용률이 100%라면, 해당 JVM은 그 시점에 하나의 CPU 코어를 전적으로 사용하고 있다는 것을 나타낼 수 있습니다. 하지만 이것은 다른 코어들이 여전히 다른 프로세스나 작업에 사용될 수 있다는 것을 의미합니다.
- 예를 들어, 4코어 CPU 시스템에서 JVM 프로세스의 CPU 사용률이 100%라면:
- JVM은 1코어를 완전히 사용하고 있습니다. 나머지 3코어는 다른 프로세스나 작업에 의해 사용될 수 있습니다. 그러나, JVM이 여러 스레드를 사용하여 병렬 작업을 수행하고 있고, 모든 코어에서 JVM 스레드가 실행되고 있다면, JVM의 CPU 사용률은 전체 시스템의 사용률에 큰 영향을 줄 수 있습니다.
- CPU 사용률이 100%에 가깝다고 해서 특정 순간에 다른 처리를 전혀 못 하는 것은 아닙니다. 그러나, CPU가 계속해서 과부하 상태로 운영되면 시스템의 응답 시간이 느려지거나, 다른 프로세스나 작업들이 충분한 CPU 자원을 할당받지 못할 수 있습니다.
디비 서버의 자원 사용률
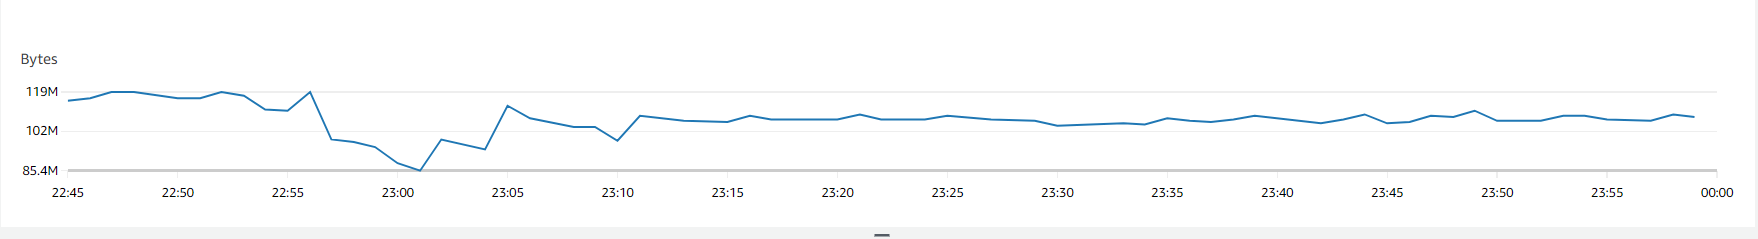
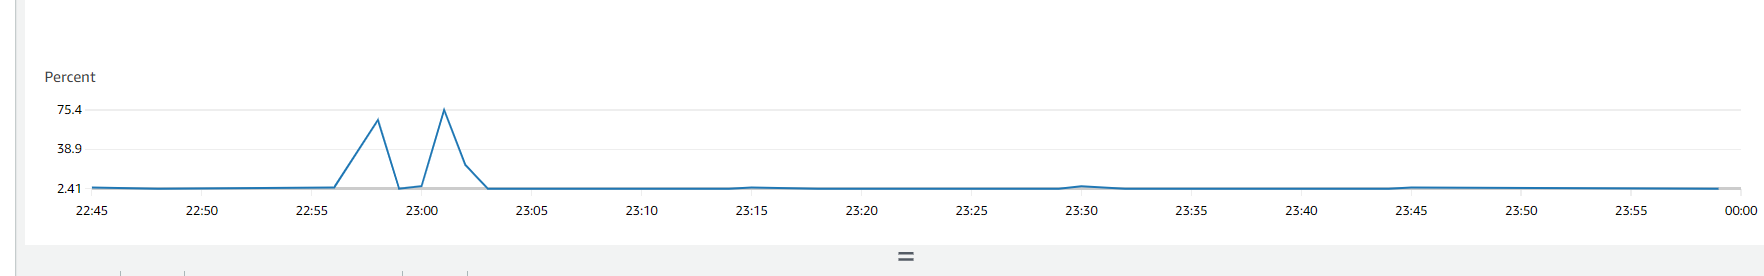
- 데이터베이스 서버의 CPU사용률과 메모리 사용률을 확인해보면 23시 근처에 매우 높아진 것을 확인할 수 있었습니다.
- 메모리 부족 상태에서는 새로운 연결을 수립하는 데 필요한 메모리 할당이 지연될 수 있으므로, getConnection() 호출의 지연 원인이 될 수 있습니다.
또한 높은 CPU 사용률은 DB 인스턴스의 응답 시간을 늦출 수 있으며, 이는 getConnection() 호출의 지연 원인이 될 수 있습니다. - getConnection()의 늦은 응답시간 문제가 발생하지 않는 다른 API 요청에 대해 디비 서버 자원사용량을 확인해본 결과CPU사용률과 메모리 사용량이 높지 않은 것으로 보아 조사하고자 하는 API에 많은 자원이 소비되고, 이에 따라 getConnection()의 늦은 응답시간 문제가 발생한다고 추측하였습니다.
스케일업
- connection pool size를 늘려봤는데도 느린 응답시간에 변화가 없었기에, 서버 사양 측에 문제가 있다고 판단하여
- db.t3.micro -> db.t3.small 로 업그레이드를 하였습니다
- CPU의 개수는 2개로 같고, 메모리가 1GB->2GB로 두배 증가하였습니다
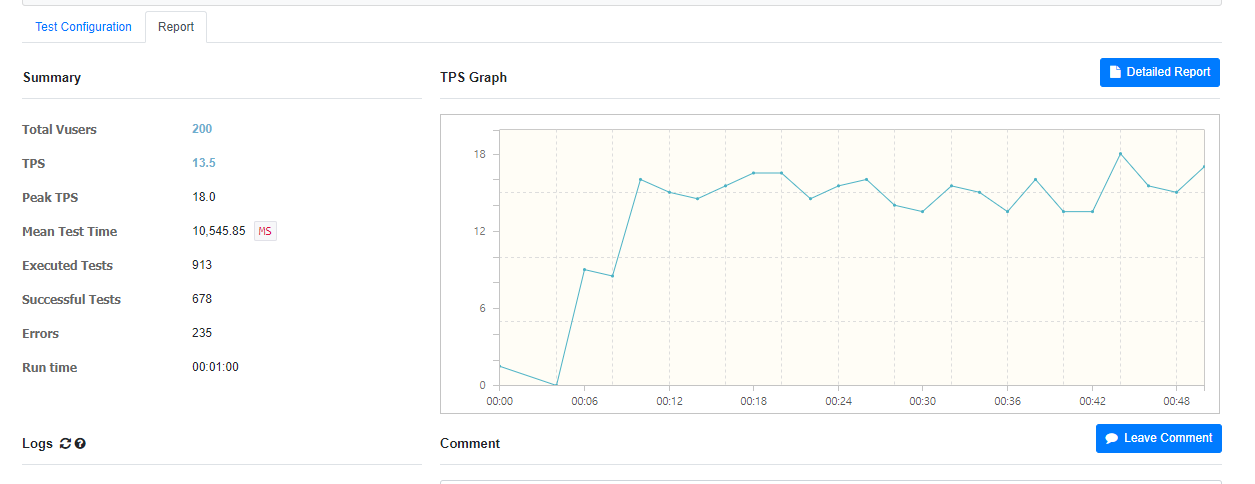
- 응답시간이나 TPS모두 이전과 큰 차이가 없는것을 확인할 수 있었습니다.
- 다음으론 db.t3.small -> db.t3.xlarge으로 스케일 업을 진행해 보았는데요
- Cpu 개수는 2 -> 4개로 증가하고, 메모리의 사이즈도 2GB -> 16GB로 증가하였습니다
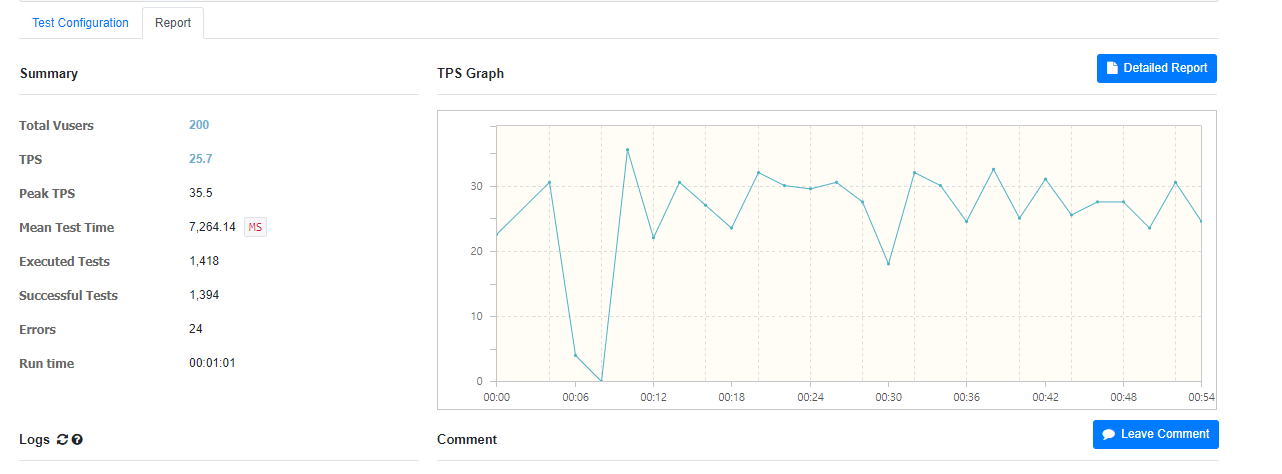
- 스케일 업을 통해서도 성능 개선이 어느정도는 이루어지는 것 같으나 그 정도가 미미하였습니다.
- 이로 인해 서버 자원의 문제는 아니라고 판단을 한 뒤 쿼리 튜닝에 대해 진행해보았습니다
쿼리 개선
- https://flrefly.tistory.com/24
- 위의 블로그 글을 참고해주세요
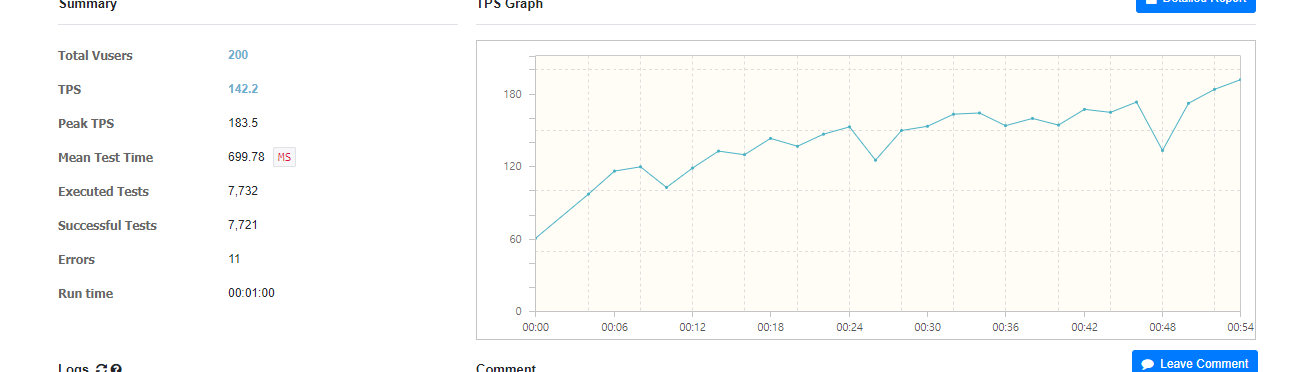
- 쿼리 개선이후엔 TPS값도 이전 값(25) 보다 5배 가량 정도 증가하였고,
MTT 값도 7초 -> 1초 이내로 크게 감소한것을 확인할 수 있었습니다.
결론
- 쿼리 튜닝 후, API의 응답 시간이 7초에서 1초로 크게 감소하였습니다. 이로 인해 사용자 경험이 향상되었으며, 서비스의 안정성도 크게 개선되었습니다.
- 적절한 서버 스케일링과 쿼리 최적화를 통해, 더 많은 트래픽을 더 적은 리소스로 처리할 수 있게 되었습니다. 이는 장기적으로 팀의 비용 절감과 효율적인 리소스 관리에 기여한다고 생각합니다.
'문제해결' 카테고리의 다른 글
| Reddisson을 활용한 동시성 문제 해결 (1) | 2023.10.04 |
|---|---|
| 로드밸런싱을 통한 높은 CPU 점유율 해결하기 (0) | 2023.09.18 |
| 프로젝트 동시성 문제 해결 - 데이터베이스 조건 (0) | 2023.09.07 |
| 서버 응답 없는 현상 해결하기 (메모리 부족) (0) | 2023.09.07 |
| s3mock 도입 (0) | 2023.09.07 |